Hangi test, ne zaman, neden?
Sosyal bilimlerden sağlık bilimlerine, fen bilimlerinden kurumsal veriye — alan fark etmeksizin temel ilke aynı: verinin doğru yöntemle analiz edilmesi. Burada temel istatistiksel yöntemleri gerçek örnek çıktılarla ve farklı sektörlerden örneklerle anlatıyoruz.

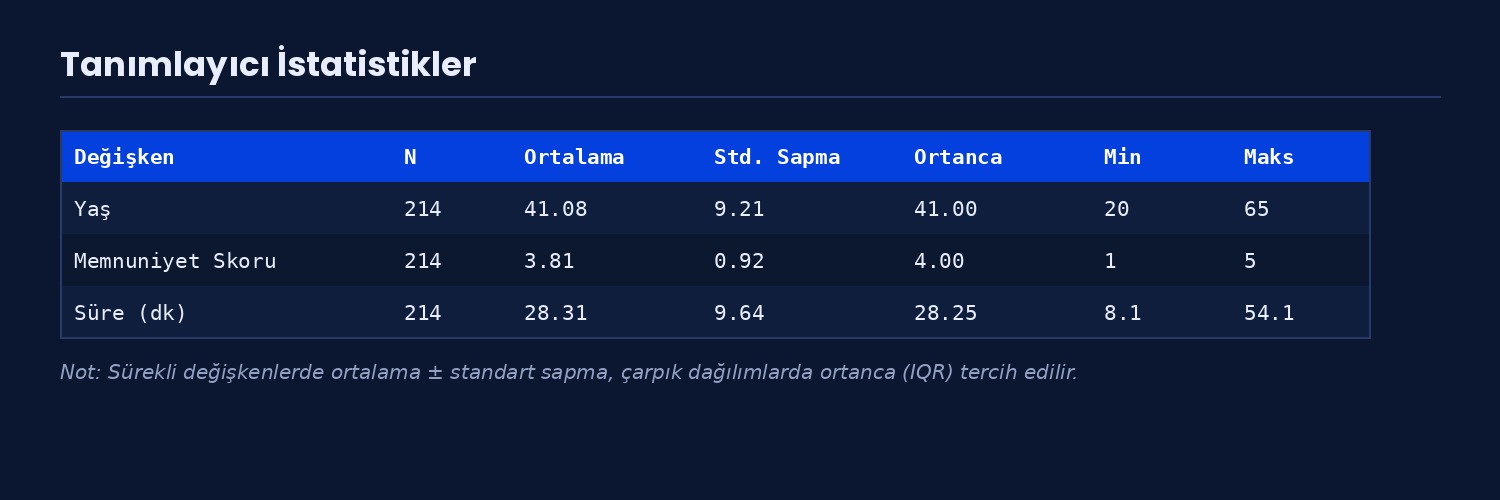
Tanımlayıcı İstatistikler
Her istatistiksel analiz, verinin fotoğrafını çekmekle başlar. Tanımlayıcı istatistikler, elinizdeki verinin ortalamasını, dağılımını ve genel eğilimini sayılarla özetleyen ilk adımdır. Bir hipotez testi kurmadan, bir model çalıştırmadan önce verinin nasıl dağıldığını görmeden ilerlemek, yanlış yöntem seçme riskini beraberinde getirir.
Sürekli bir değişkenin — yaş, gelir, üretim süresi gibi — merkezi eğilimini ortalama, medyan veya mod ile; yayılımını ise standart sapma, varyans ya da çeyrekler arası açıklıkla ifade ederiz. Kategorik bir değişkende — cinsiyet, ürün kategorisi, vardiya türü gibi — frekans ve yüzde tabloları esas alınır.
Verinin çarpık mı yoksa simetrik mi dağıldığı, hangi merkezi eğilim ölçüsünün daha güvenilir olduğunu belirler; çarpık bir dağılımda ortalama yanıltıcı olabilirken medyan gerçeği daha iyi yansıtır. Bu yüzden tanımlayıcı istatistikleri, sonraki adımda hangi testin — parametrik ya da değil — kullanılacağına karar verirken de referans alırız.
Raporlarda sürekli değişkenler genellikle "ortalama ± standart sapma" ya da "medyan (çeyrekler arası açıklık)" formatında, kategorik değişkenler ise "n (%)" formatında sunulur. Kısacası tanımlayıcı istatistikler, karmaşık modellemeden önce atılan ama hiçbir zaman atlanmaması gereken temel adımdır.
- Kategorik veri (cinsiyet, ürün türü) → frekans, yüzde, mod
- Sıralı (ordinal) veri (memnuniyet 1–5 skalası) → medyan, çeyrekler arası açıklık
- Sürekli & normal dağılan veri (boy, sıcaklık) → ortalama ± standart sapma
- Sürekli & çarpık dağılan veri (gelir, bekleme süresi) → medyan (IQR)
Normal Dağılım & Normallik Testleri
Normal dağılım (Gauss eğrisi), verinin ortalama etrafında simetrik ve çan şeklinde yayıldığı varsayımıdır. Pek çok parametrik testin — t-testi, ANOVA, Pearson korelasyonu — arkasında bu varsayım yatar; veri bu varsayımı karşılamıyorsa, testin sonuçları yanıltıcı olabilir.
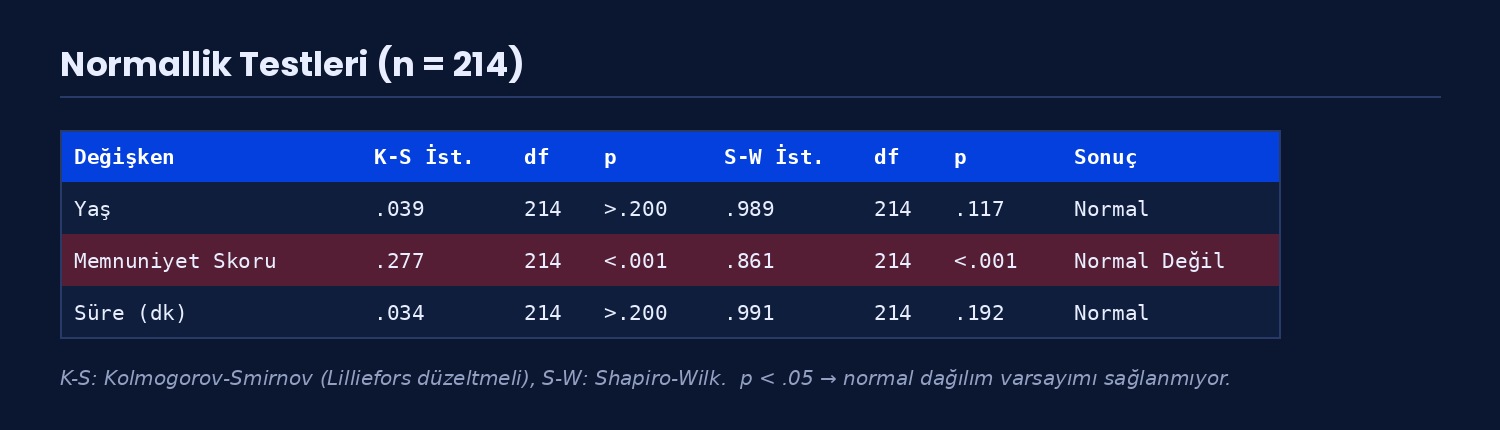
Normalliği görsel olarak histogram ve Q-Q grafiğiyle, istatistiksel olarak ise örneklem büyüklüğüne göre Shapiro-Wilk (n<50 için daha güçlü) veya Kolmogorov-Smirnov testiyle kontrol ederiz. Çarpıklık (skewness) ve basıklık (kurtosis) değerlerinin ±1 ile ±1.5 aralığında kalması da pratikte kabul edilebilir normallik göstergesi sayılır.
- Test p değeri > .05 → normallik varsayımı korunur, parametrik testler kullanılabilir
- Test p değeri < .05 → normallik sağlanmıyor, parametrik olmayan (non-parametrik) alternatif tercih edilir
- Büyük örneklemlerde (n>100) normallik testleri aşırı hassas olabilir; histogram/Q-Q grafiğiyle birlikte değerlendirilmelidir
t-Testi
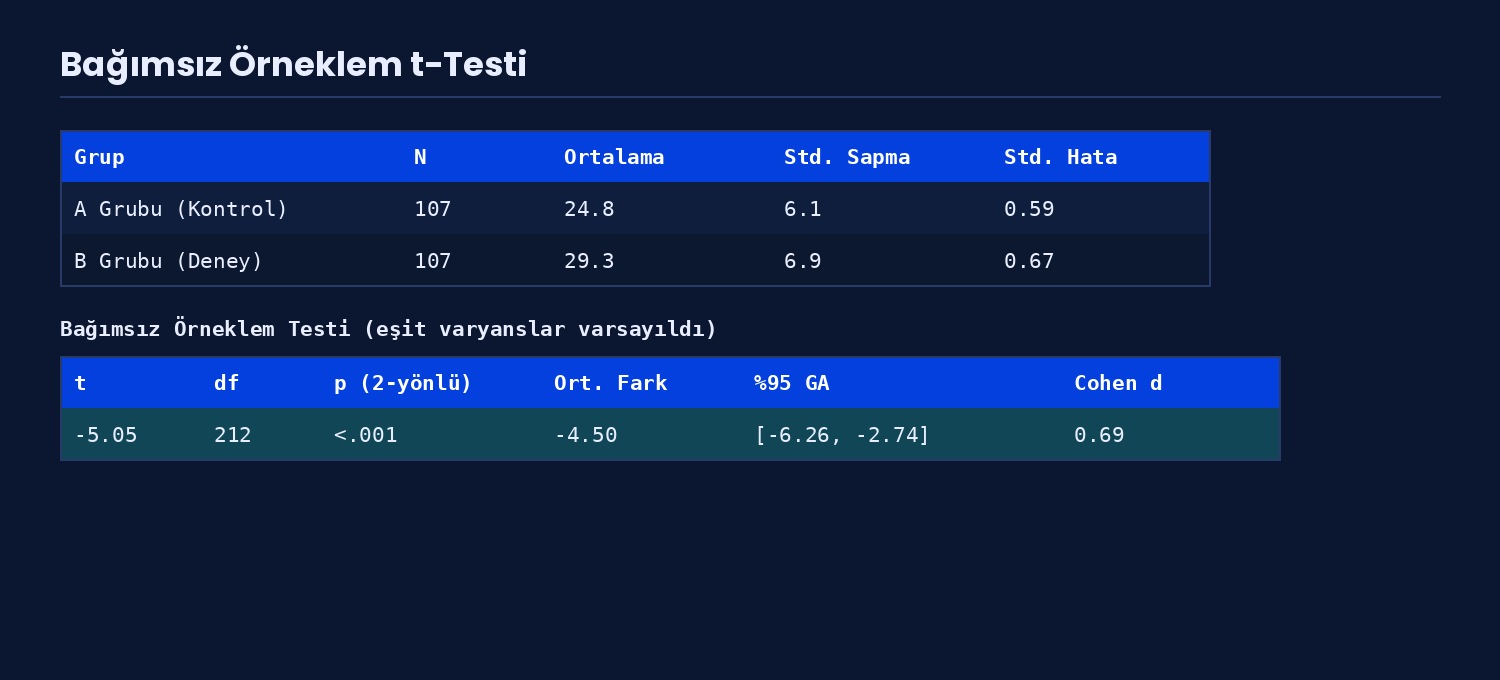
t-Testi, iki grubun ortalamasını karşılaştırıp aradaki farkın rastlantısal mı yoksa istatistiksel olarak anlamlı mı olduğunu sınar. Üç ana türü vardır: bağımsız örneklem t-testi (iki farklı grubu karşılaştırır — örn. deney/kontrol), eşleştirilmiş örneklem t-testi (aynı grubun ön-test/son-test ölçümlerini karşılaştırır) ve tek örneklem t-testi (bir grubun ortalamasını bilinen bir referans değerle karşılaştırır).
Testin güvenilir olması için verinin normal dağılması ve — bağımsız örneklem durumunda — grupların varyanslarının homojen olması (Levene testiyle kontrol edilir) beklenir. Sonuç yorumlanırken yalnızca p değeri değil, farkın büyüklüğünü gösteren Cohen's d etki büyüklüğü de dikkate alınmalıdır; çünkü çok büyük örneklemlerde çok küçük farklar bile "anlamlı" çıkabilir.
- p < .05 → iki grup ortalaması arasında istatistiksel olarak anlamlı fark vardır
- Cohen's d ≈ 0.2 küçük, ≈ 0.5 orta, ≈ 0.8 büyük etki büyüklüğü olarak yorumlanır
- %95 güven aralığının sıfırı içermemesi, farkın anlamlılığını destekler
ANOVA
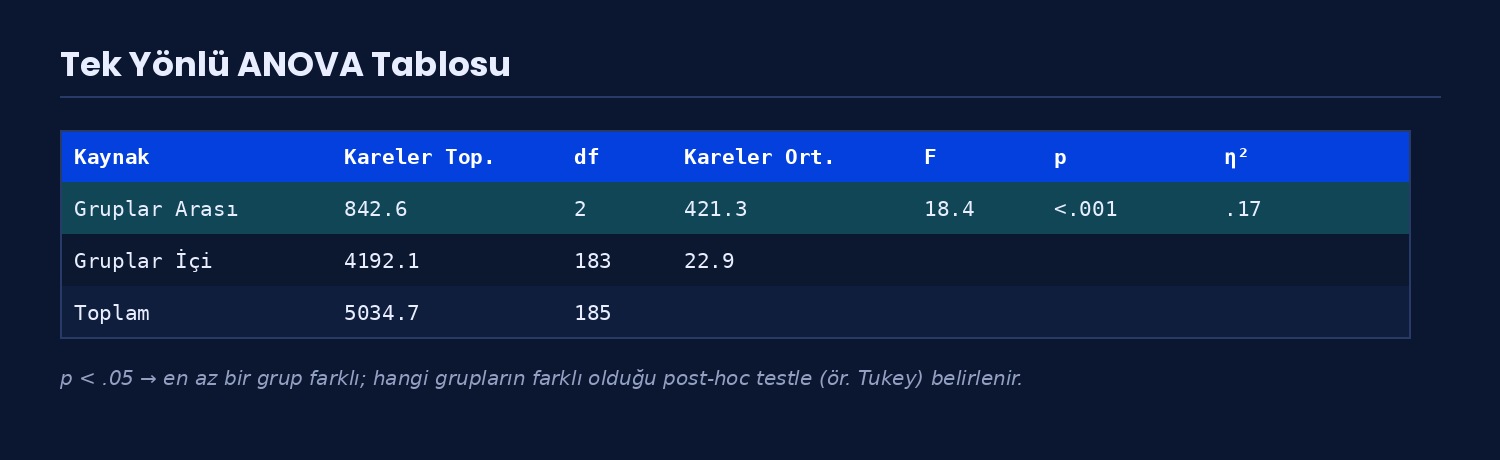
İkiden fazla grubun ortalamasını aynı anda karşılaştırmak gerektiğinde art arda t-testleri yapmak, hata payını büyütür — burada devreye ANOVA (varyans analizi) girer. Tek yönlü ANOVA tek bir faktöre göre (örn. üç farklı vardiya) grupları karşılaştırırken, çok yönlü (faktöriyel) ANOVA birden fazla faktörün ve bunların etkileşiminin etkisini birlikte inceler; tekrarlı ölçümler ANOVA'sı ise aynı grubun zaman içindeki birden çok ölçümünü karşılaştırır.
ANOVA sonucu anlamlı çıktığında yalnızca "en az bir grup farklı" olduğunu söyler; hangi grupların birbirinden farklı olduğunu görmek için Tukey, Bonferroni veya Scheffe gibi post-hoc (ileri) testler uygulanır. Varsayımlar t-testine benzer: normallik ve grup varyanslarının homojenliği (Levene testi).
- F değeri büyüdükçe ve p < .05 olduğunda, gruplar arasında en az bir anlamlı fark olduğu kabul edilir
- Hangi grupların farklı olduğu, ANOVA'dan sonra mutlaka post-hoc testle netleştirilmelidir
- Eta-kare (η²) etki büyüklüğü, faktörün toplam varyansın ne kadarını açıkladığını gösterir
Korelasyon Analizi
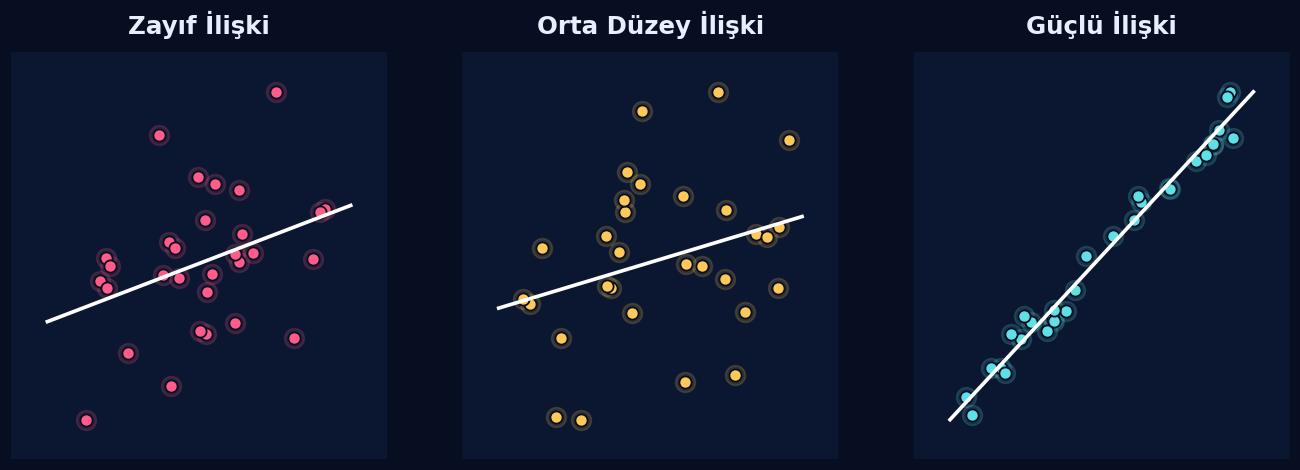
Korelasyon analizi, iki sürekli değişken arasındaki ilişkinin yönünü ve gücünü ölçer — biri artarken diğeri de mi artıyor, yoksa azalıyor mu? Sonuç, -1 ile +1 arasında bir korelasyon katsayısı (r) ile ifade edilir: +1'e yaklaştıkça güçlü pozitif, -1'e yaklaştıkça güçlü negatif, 0'a yaklaştıkça zayıf bir ilişkiyi işaret eder.
Veri normal dağılıyorsa Pearson korelasyon katsayısı, normal dağılmıyorsa ya da sıralı (ordinal) ölçekteyse Spearman sıra korelasyonu kullanılır. Önemli bir uyarı: korelasyon, nedensellik anlamına gelmez — iki değişken birlikte hareket ediyor diye biri diğerinin sebebi olduğu sonucuna varılamaz.
- |r| ≈ 0.1–0.3 zayıf, ≈ 0.3–0.5 orta, ≈ 0.5+ güçlü ilişki olarak yorumlanır
- p değeri, ilişkinin rastlantısal olma ihtimalini; r değeri ise ilişkinin gücünü gösterir — ikisi farklı şeylerdir
- Bir saçılım grafiği (scatter plot) çizmeden yalnızca r değerine güvenmek yanıltıcı olabilir
Regresyon Analizi
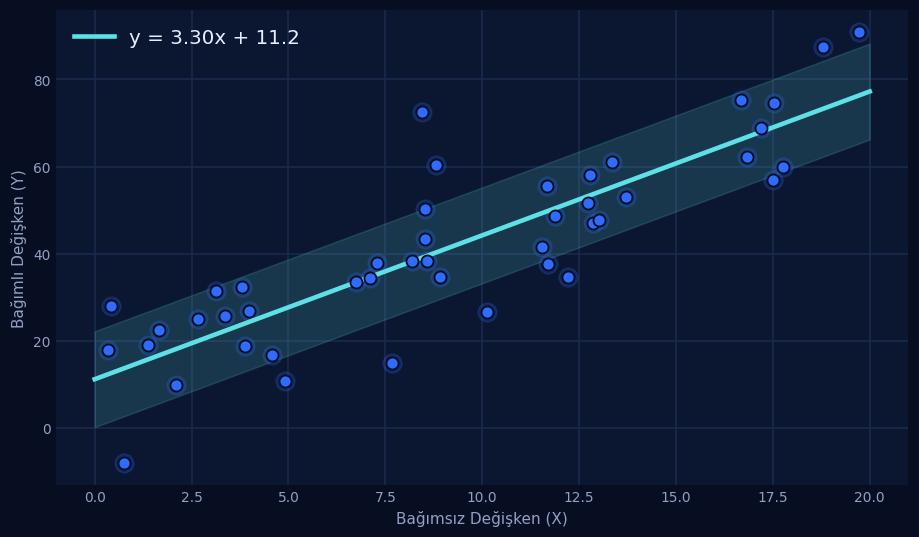
Korelasyon iki değişken arasındaki ilişkinin varlığını gösterirken, regresyon analizi bir adım öteye geçip bu ilişkiyi bir denkleme döker ve bağımsız değişken(ler)den bağımlı değişkeni tahmin etmeyi hedefler. Tek bir bağımsız değişken varsa basit doğrusal regresyon, birden fazla varsa çoklu doğrusal regresyon kurulur; bağımlı değişken kategorik (evet/hayır gibi) olduğunda ise lojistik regresyon kullanılır.
Model kurulduktan sonra R² değeri, bağımsız değişken(ler)in bağımlı değişkendeki değişimin yüzde kaçını açıkladığını gösterir. Modelin güvenilir olması için doğrusallık, hataların (artıkların) normal dağılması, sabit varyans (homoskedastisite) ve bağımsız değişkenler arası çoklu doğrusal bağlantı (multicollinearity) olmaması gibi varsayımlar kontrol edilir.
- Regresyon katsayısı (β), bağımsız değişken bir birim arttığında bağımlı değişkenin ne kadar değiştiğini gösterir
- R² değeri 1'e yaklaştıkça model verideki değişimi daha iyi açıklar
- p < .05 olan bir katsayı, o değişkenin modelde istatistiksel olarak anlamlı bir katkısı olduğunu gösterir
Parametrik Olmayan Testler
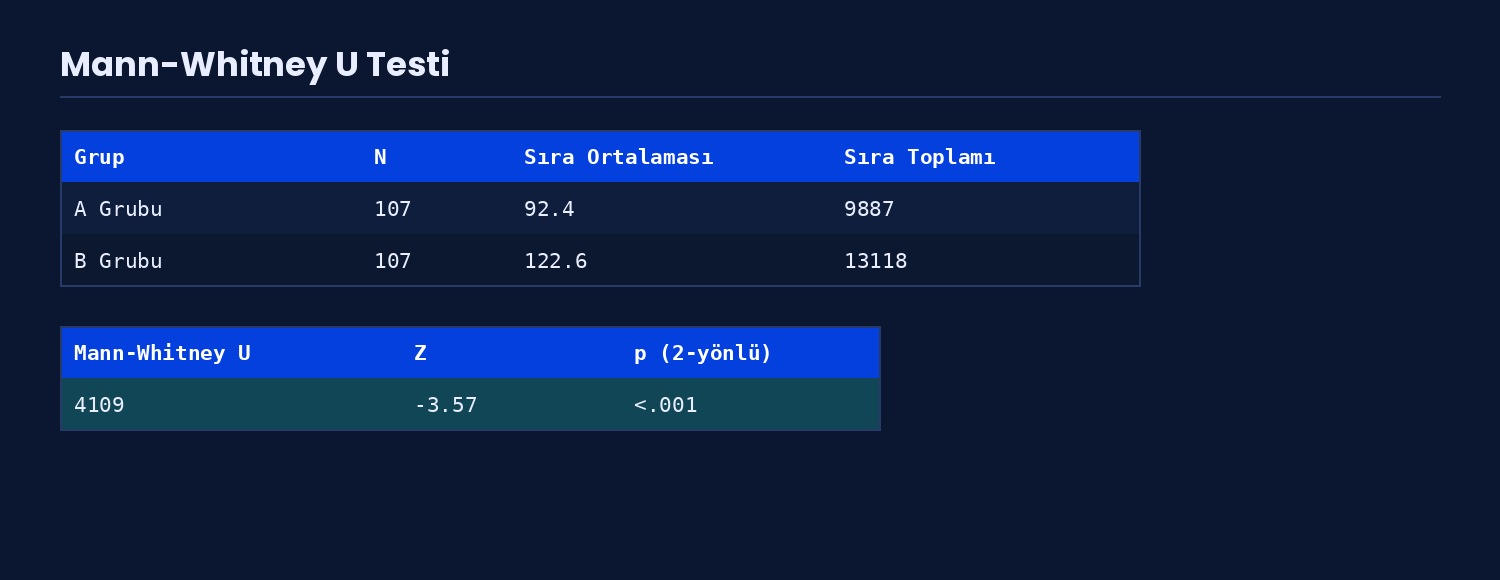
Veri normallik varsayımını karşılamadığında, örneklem küçük olduğunda ya da değişken sıralı (ordinal) ölçekte olduğunda, parametrik testlerin dağılımdan bağımsız (non-parametrik) alternatifleri devreye girer. Bu testler ortalama yerine sıra (rank) değerleriyle çalışır, bu yüzden aykırı değerlere karşı da daha dayanıklıdır.
En sık kullanılan üç non-parametrik test şöyle eşleşir: Mann-Whitney U, bağımsız örneklem t-testinin; Wilcoxon işaretli sıralar testi, eşleştirilmiş örneklem t-testinin; Kruskal-Wallis testi ise tek yönlü ANOVA'nın non-parametrik karşılığıdır. Kategorik değişkenler arası ilişki için ise ki-kare bağımsızlık testi kullanılır.
- Yorumlama mantığı parametrik testlerle aynıdır: p < .05 → anlamlı fark/ilişki vardır
- Sonuç, grupların ortalaması değil "sıra ortalaması" üzerinden raporlanır
- Küçük örneklemlerde (n<30) ve Likert tipi ölçeklerde genellikle ilk tercih non-parametrik testlerdir
Ki-Kare Bağımsızlık Testi
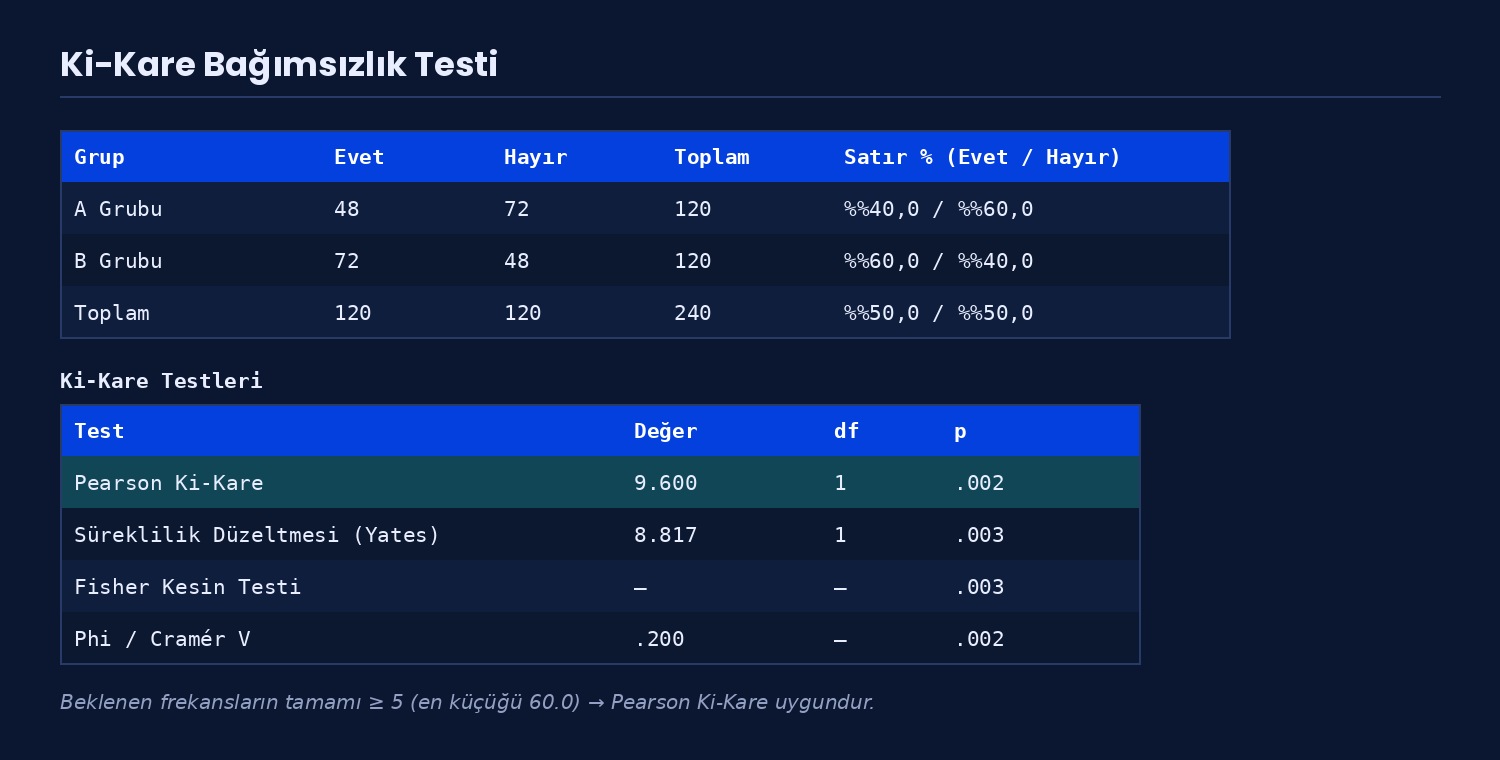
Ki-kare bağımsızlık testi, iki kategorik değişken arasında bir ilişki olup olmadığını sınar — t-testi ve ANOVA sürekli değişkenler için neyse, ki-kare de kategorik değişkenler için odur. "Departman ile işten ayrılma durumu arasında bir ilişki var mı?", "ürün kategorisi ile iade nedeni arasında bir bağlantı var mı?" gibi sorularda kullanılır.
Test, gözlenen frekanslarla (gerçek veri) beklenen frekansları (iki değişken tamamen bağımsız olsaydı beklenecek dağılım) karşılaştırır. Beklenen hücre frekanslarının tamamının 5 ve üzerinde olması beklenir; küçük örneklemlerde bu sağlanmazsa Fisher'ın kesin testi (Fisher's Exact Test) tercih edilir. 2x2 tablolarda süreklilik düzeltmesi (Yates düzeltmesi) uygulanmış ki-kare değeri de genellikle birlikte raporlanır.
Önemli bir sınır: ki-kare bağımsızlık testi bağımsız gözlemler içindir. Aynı kişilerin iki ölçümünde (ör. önce–sonra, evet/hayır) ikili bir sonucun değişip değişmediğini sınamak için McNemar testi, aynı kişilerin üç veya daha fazla ölçümünde ise Cochran's Q testi kullanılır; bu durumlarda ölçümler birbirine bağlı olduğu için klasik ki-kare uygun değildir.
- p < .05 → iki değişken arasında istatistiksel olarak anlamlı bir ilişki vardır
- İlişkinin gücü phi (2x2 tablolarda) veya Cramér's V (daha büyük tablolarda) etki büyüklüğü katsayısıyla raporlanır
- Anlamlı bir sonuç, nedensellik değil yalnızca birliktelik gösterir
Faktör Analizi & Güvenirlik
Bir anket ya da ölçekteki onlarca maddenin aslında kaç gizli boyutu (faktörü) ölçtüğünü ortaya çıkarmak için açımlayıcı faktör analizi (AFA) kullanılır. Örneğin 20 maddelik bir iş tatmini anketi, aslında "ücret memnuniyeti", "yönetici ilişkisi" ve "çalışma ortamı" gibi birkaç alt boyuta indirgenebilir — bu da hem anketi yorumlamayı kolaylaştırır hem de istatistiksel olarak daha sağlam bir yapı sağlar.
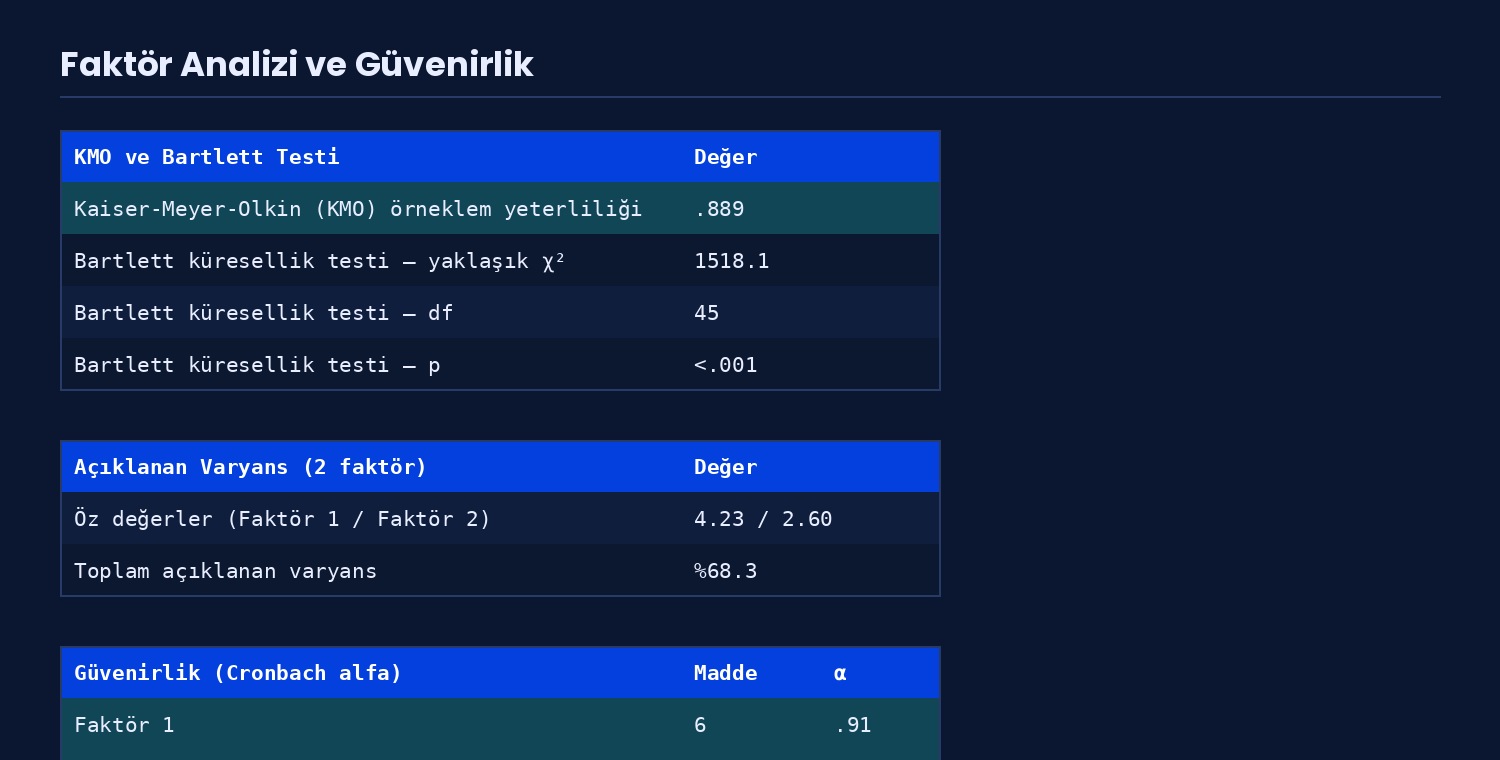
Analize başlamadan önce verinin faktör analizine uygun olup olmadığı KMO örneklem yeterliliği testi (≥ .60 beklenir) ve Bartlett küresellik testi (p < .05 beklenir) ile kontrol edilir. Her maddenin hangi faktöre ait olduğu faktör yük değerleriyle (genellikle ≥ .40 eşiği) belirlenir. Yapı netleştikten sonra, her alt boyutun iç tutarlılığı Cronbach alfa katsayısıyla raporlanır.
- KMO ≥ .60 ve Bartlett p < .05 → veri faktör analizi için uygundur
- Öz değeri (eigenvalue) 1'in üzerinde olan faktörler genellikle anlamlı kabul edilir
- Cronbach alfa ≥ .70 kabul edilebilir, ≥ .80 iyi düzeyde güvenirlik olarak yorumlanır
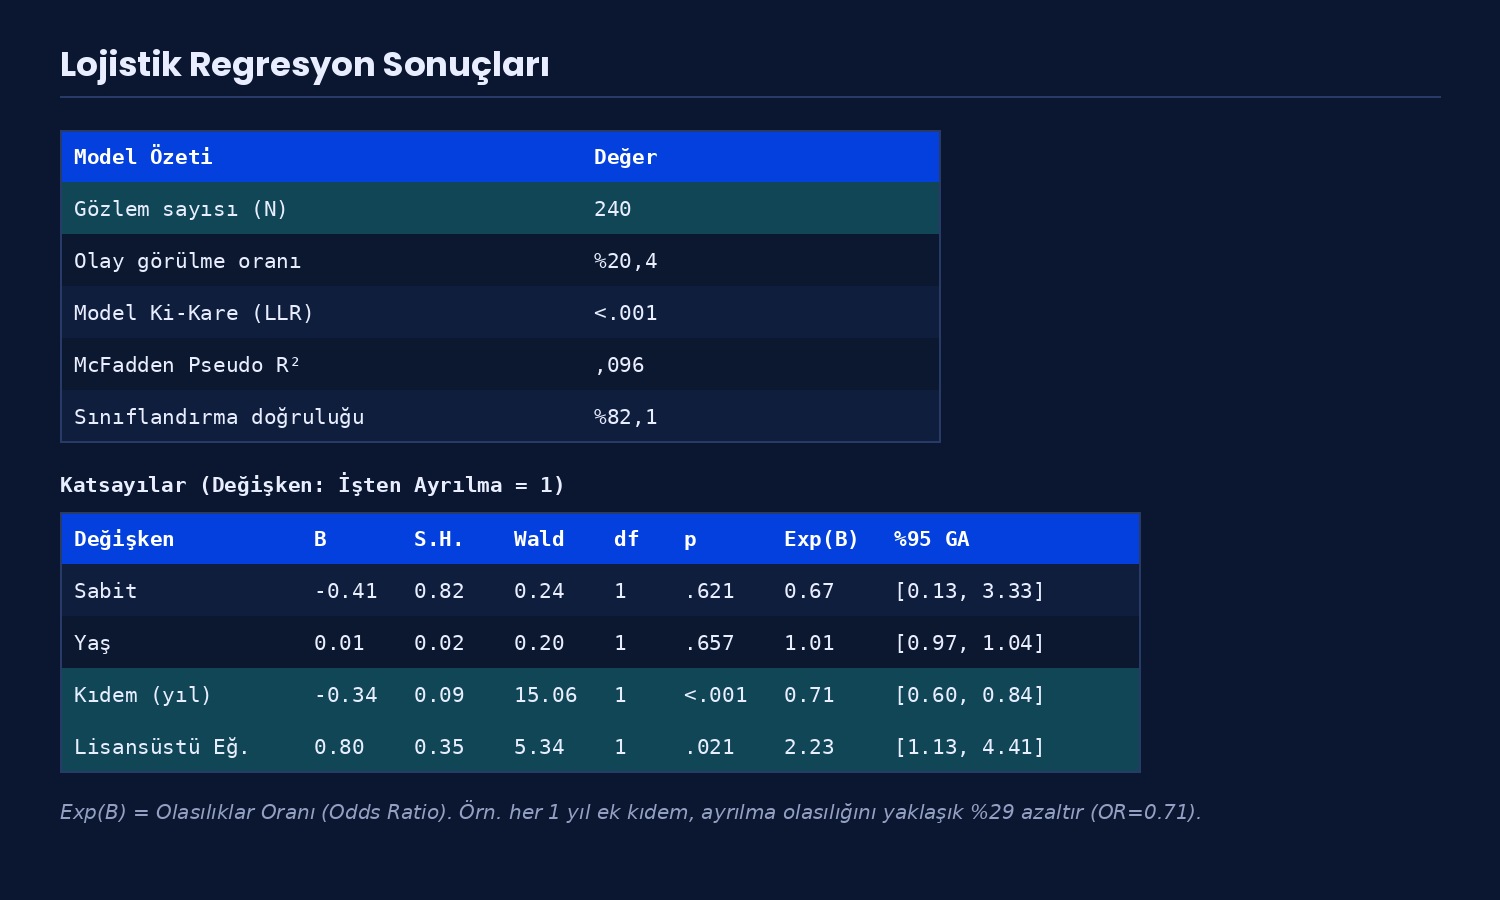
Lojistik Regresyon
Doğrusal regresyon sürekli bir sonucu tahmin ederken, sonucunuz ikili (evet/hayır, var/yok, ayrıldı/kaldı gibi) olduğunda lojistik regresyon devreye girer. Doğrudan "olur mu olmaz mı" tahmini yerine, bir olayın gerçekleşme olasılığını — 0 ile 1 arasında bir değer olarak — modeller.
Katsayılar doğrudan yorumlanmaz; önce Exp(B)'ye, yani olasılıklar oranına (odds ratio) çevrilir. Exp(B) = 1 ise bağımsız değişkenin etkisi yok demektir; 1'in üzerindeki değerler olayın gerçekleşme olasılığını artırdığını, 1'in altındaki değerler azalttığını gösterir. Modelin bütünsel başarısı Pseudo R² (ör. McFadden) ve sınıflandırma doğruluğuyla, genel anlamlılığı ise model ki-kare (LLR) testiyle raporlanır.
- p < .05 olan bir değişkenin modelde istatistiksel olarak anlamlı bir katkısı vardır
- Exp(B) = 2.0 → o değişken bir birim arttığında, olayın gerçekleşme olasılığı yaklaşık 2 kat artar
- Pseudo R² doğrusal regresyondaki R² ile birebir aynı şekilde yorumlanmaz; daha düşük değerler normaldir
Hangi analize ihtiyacınız olduğundan emin değil misiniz?
Verinizi ve araştırma sorunuzu anlatın, size en uygun yöntemi birlikte belirleyelim.
Ön görüşme talep edin